万神殿 Patheon:零知识证明开发框架评测平台
我们要感谢 Polygon Zero 团队、Consensys gnark 项目、Pado Labs 和 Delphinus Lab 团队对本篇文章的宝贵评论和反馈。
零知识证明开发框架评测平台
「万神殿 Patheon」
过去几个月,我们投入了大量时间和精力,开发了利用 zk-SNARK 简洁证明构建的前沿基础设施。这个次世代创新平台使开发者能够构建前所未有的区块链应用新范例。
在开发工作中,我们测试并使用了多种零知识证明 (ZKP) 开发框架。虽然这段旅程收获颇丰,但我们也确实意识到,当新的开发者试图找到最适合其特定用例和性能要求的框架时,多种多样的 ZKP 框架通常会给他们带来挑战。考虑到这一痛点,我们认为需要一个能够提供全面性能测试结果的社区评估平台,这将极大地促进这些新应用的开发。
为了满足这一需求,我们推出了零知识证明开发框架评测平台「万神殿 Patheon」 这一公益社区倡议。倡议的第一步将鼓励社区分享各种 ZKP 框架的可复现性能测试结果。我们的最终目标是共同协作创建并维护一个广受认可的测试平台,评估低级电路开发框架、高级 zkVM 和编译器,甚至硬件加速提供商。我们希望这一举措能够让开发者们在选用框架时能有更多性能比较的参考,从而加快 ZKP 的推广。同时,我们希望通过提供一组普遍可参考的性能测试结果,促进 ZKP 框架本身的升级和迭代。我们将大力投入这项计划,并邀请所有志同道合的社区成员加入我们,共同为这项工作做出贡献!
第一步:使用 SHA-256 对电路框架进行性能测试
在这篇文章中,我们迈出了构建 ZKP Patheon 的第一步,在一系列低级电路开发框架中使用 SHA-256 提供一组可复现的性能测试结果。虽然我们承认其他性能测试粒度和原语或许也是可行的,但我们选择 SHA-256 是因为它适用于广泛的 ZKP 用例,包括区块链系统、数字签名、zkDID 等。另外值得一提的是,我们在自己的系统中也使用了 SHA-256,所以这对我们来说也很方便!?
我们的性能测试评估了 SHA-256 在各种 zk-SNARK 和 zk-STARK 电路开发框架上的性能。通过比较,我们力求为开发者提供关于每个框架的效率和实用性的见解。我们的目标是,希望本次性能测试结果能够为开发者在选择最佳框架时提供参考,使之做出明智的决定。
证明系统
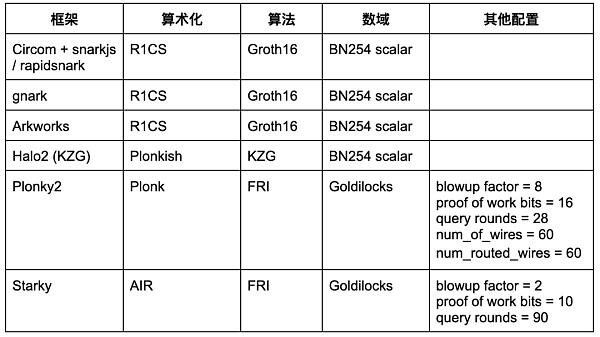
近年来,我们观察到零知识证明系统激增。跟上该领域所有激动人心的进步是具有挑战性的,我们根据成熟度和开发者采用情况精心挑选了以下证明系统作为测试对象。我们的目标是提供不同前端/后端组合的代表性样本。
下表总结了上述框架以及我们性能测试中使用的相关配置。这个列表绝不是详尽的,我们还将在未来研究许多最先进的框架/技术(例如,Nova、GKR、Hyperplonk)。
请注意,这些性能测试结果仅适用于电路开发框架。我们计划在未来发布一篇单独的文章,对不同的 zkVM(例如,Scroll、Polygon zkEVM、Consensys zkEVM、zkSync、Risc Zero、zkWasm)和 IR 编译器框架(例如,Noir、zkLLVM)进行性能测试。
性能评测方法论
为了对这些不同的证明系统进行性能测试,我们计算了 N 字节数据的 SHA-256 哈希值,其中我们对 N = 64、128、...、64K 进行了实验(Starky 是一个例外,其中电路重复 SHA-256 固定 64 字节输入的计算,但保持相同的消息块总数)。可以在此存储库(https://github.com/celer-network/zk-benchmark)中找到性能代码和 SHA-256 电路配置。
此外,我们使用以下性能指标对每个系统进行了性能测试:
请注意,我们正在对证明大小和证明验证成本做一些“随意”的假设,因为这些方面可以通过在上链之前与 Groth16 或 KZG 组合来减轻。
机器
我们在两台不同的机器上进行了性能测试:
Linux 服务器用于模拟 CPU 核数多、内存充裕的场景。而通常用于研发的 Macbook M1 Pro 拥有更强大的 CPU,但内核较少。
我们启用了可选的多线程,但我们没有在此性能测试中使用 GPU 加速。我们计划在未来进行GPU 性能测试。
性能评测结果
约束数量
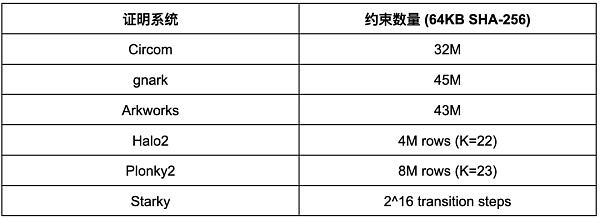
在我们继续讨论详细的性能测试结果之前,首先通过查看每个证明系统中的约束数量来了解 SHA-256 的复杂性是很有用的。重要的是要注意不能直接比较不同算术方案中的约束数量。
下面的结果对应 64KB 的原像尺寸。虽然结果可能因其他原像尺寸而异,但它们可以粗略地线性缩放。
证明生成时间
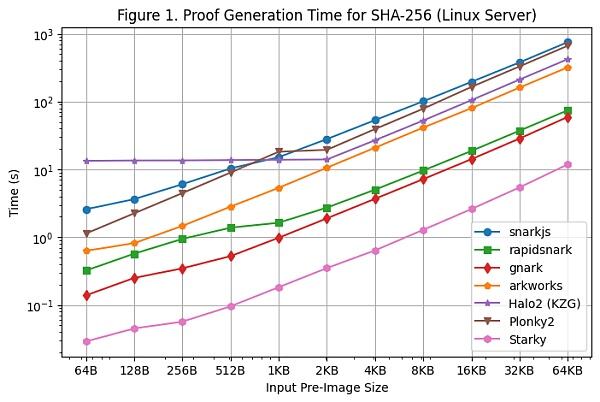
[图 1] 使用 Linux 服务器测试了 SHA-256 的每个框架在各种原图像尺寸上的证明生成时间。我们可以得到以下发现:
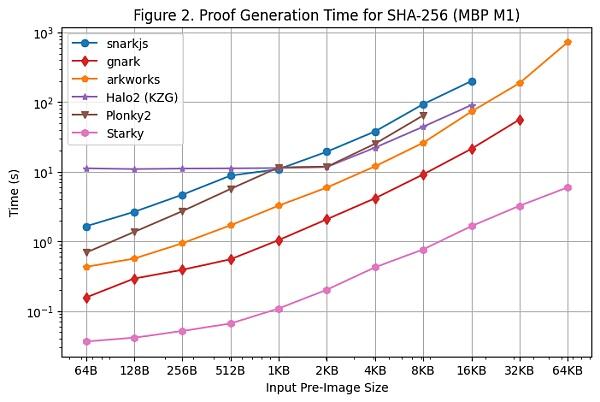
我们还在 Macbook M1 Pro 上进行了证明生成时间性能测试,如 [图 2] 所示。但是,需要注意的是,由于缺乏对 arm64 架构的支持,rapidsnark 未包含在该性能测试中。为了在 arm64 上使用 snarkjs,我们必须使用 webassembly 生成见证,这比 Linux 服务器上使用的 C 见证生成要慢。
在 Macbook M1 Pro 上运行性能测试时还有几个额外的观察结果:
内存使用峰值
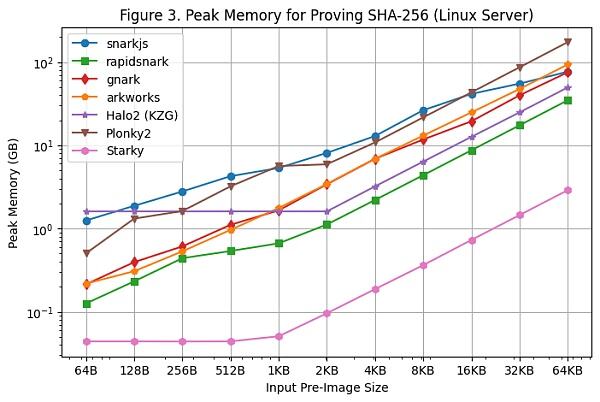
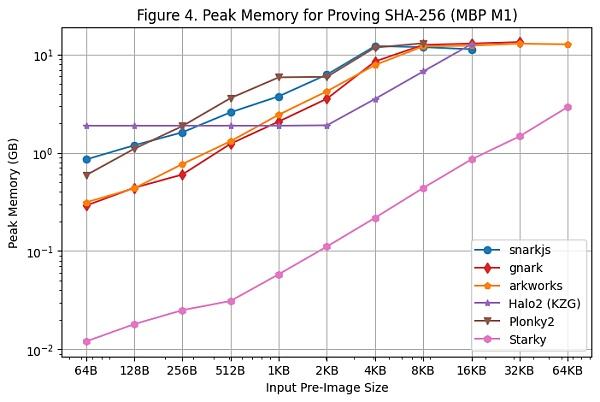
[图 3] 和 [图 4] 分别显示了在 Linux Server 和 Macbook M1 Pro 上生成证明期间的内存使用峰值。根据这些性能测试结果可以得出以下观察结果:
CPU 利用率
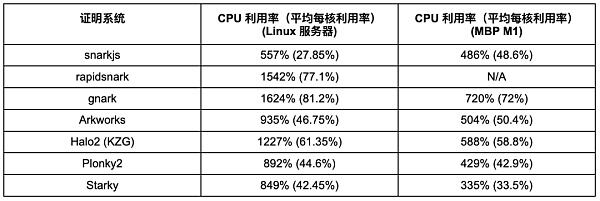
我们通过测量 SHA-256 在 4KB 原像输入的证明生成期间的平均 CPU 利用率来评估每个证明系统的并行化程度。下表显示了 Linux Server(20 核)和 Macbook M1 Pro(10 核)上的平均 CPU 利用率(括号中为每个内核的平均利用率 ) 。
主要观察结果如下:
结论及未来研究
温馨提示:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。
免责声明:本文为转载,非本网原创内容,不代表本网观点。其原创性以及文中陈述文字和内容未经本站证实,对本文以及其中全部或者部分内容、文字的真实性、完整性、及时性本站不作任何保证或承诺,请读者仅作参考,并请自行核实相关内容。
如有疑问请发送邮件至:bangqikeconnect@gmail.com